jimyag's Blog

Kubernetes 如何增加一种可调度资源:从 Device Plugin 到 extended resource

这里的「自定义资源」指 extended resource:它像 GPU 一样,可以写入 Pod 的 resources.requestsresources.limits,并参与节点调度。它不是 CRD。

本文用两个模拟的 FPGA 设备做实验:Kind 节点注册 example.com/fpga: 2,两个 Pod 各申请一个设备并成功运行;第三个 Pod 申请三个设备时保持 Pending

先区分 CRD 和 extended resource

这两个概念解决的是不同问题:

名称作用本文是否使用
Custom Resource / CRD给 API Server 增加一种 API 对象,例如 WebApp
Extended Resource给节点增加一种可调度的资源,例如 example.com/fpga

CPU、memory 是 Kubernetes 内置资源。GPU、FPGA、加速卡数量等设备类资源,可以通过 Device Plugin 向 kubelet 注册为 extended resource。资源名称使用带域名的形式,例如 example.com/fpga,避免和 Kubernetes 内置资源冲突。

CRD 扩展的是 API 对象;extended resource 扩展的是节点上的可调度资源。Device Plugin 通过 Unix socket 接入 kubelet,报告设备列表和健康状态,并在容器创建时响应 Allocate。调度器读取节点的 capacity / allocatable,据此处理这个资源。

从注册到容器启动

  flowchart LR
    P[Pod 请求 example.com/fpga: 1] --> S[调度器读取 Node allocatable]
    S --> K[kubelet Device Manager]
    K -->|ListAndWatch| D[Device Plugin]
    K -->|Allocate| D
    D --> C[容器获得设备分配结果]

这条链路分成两步:

  1. ListAndWatch 建立节点资源视图。插件报告两个健康设备后,节点出现 example.com/fpga: 2
  2. Pod 被调度后,kubelet 调用 Allocate。插件可以返回设备节点、环境变量、挂载和 CDI 配置等容器运行时需要的信息。

因此,节点报告 2 个资源只表示总量;调度器还要扣除已分配的数量,才能判断新的 Pod 是否可以调度。

实现一个最小 Device Plugin

完整实现位于 k8sdev 502068b。代码不接入真实硬件,只模拟两个 FPGA ID,用于观察 Kubernetes 的资源注册、调度和分配链路。

1. 构造设备清单

newDevicePlugin 把设备交给 resourceManager 管理。管理器负责保存设备顺序、保护健康状态,并为 RPC 层提供快照:

1
2
3
4
5
6
7
func newDevicePlugin(resourceName string, deviceCount int) *devicePlugin {
    return &devicePlugin{
        resourceName: resourceName,
        socket:       pluginSocket(resourceName),
        manager:      newFakeResourceManager(deviceCount),
    }
}

真实 GPU 插件通常会使用设备 UUID,并在设备异常时更新设备状态。Kubernetes 只会把健康设备计入可分配资源。当前示例用 fakeResourceManager.UpdateHealth 模拟这类状态变化,并通过通知通道触发新的 ListAndWatchResponse

2. 监听 kubelet 的插件目录

插件和 kubelet 通过同一个 hostPath 目录发现 Unix socket:

1
2
3
/var/lib/kubelet/device-plugins/
├── kubelet.sock             # kubelet 提供的注册 socket
└── example.com-fpga.sock    # 本插件按资源名生成的 gRPC socket

进程启动时先删除上一次留下的 socket,再监听按资源名生成的 socket、启动 gRPC server,最后连接 kubelet.sock 完成注册。目录监听器会关注本插件 socket 的删除或重命名:kubelet 重启时删除该 socket,插件会停止当前 server、重新创建 socket,并重试注册。

1
2
3
4
5
6
_, err = pluginapi.NewRegistrationClient(conn).Register(registerCtx, &pluginapi.RegisterRequest{
    Version:      pluginapi.Version,
    Endpoint:     filepath.Base(socket),
    ResourceName: resourceName,
    Options:      &pluginapi.DevicePluginOptions{},
})

DaemonSet 只挂载 kubelet 的 device-plugin 目录;它不需要访问 Kubernetes API,也不需要 RBAC:

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
# 每个节点运行一个 Device Plugin,并让它访问本节点的 kubelet socket 目录。
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: fpga-device-plugin
  namespace: kube-system
spec:
  selector:
    matchLabels:
      app.kubernetes.io/name: fpga-device-plugin
  template:
    metadata:
      labels:
        app.kubernetes.io/name: fpga-device-plugin
    spec:
      # 允许插件运行在带有控制面污点的节点上。
      tolerations:
        - operator: Exists
      containers:
        - name: device-plugin
          image: extended-resource-device-plugin:dev
          imagePullPolicy: IfNotPresent
          securityContext:
            runAsUser: 0 # 需要在挂载目录中创建插件 socket。
          volumeMounts:
            - name: device-plugin
              mountPath: /var/lib/kubelet/device-plugins
      volumes:
        - name: device-plugin
          hostPath:
            path: /var/lib/kubelet/device-plugins
            type: Directory

3. 实现 Device Plugin RPC

Device Plugin API 涉及 GetDevicePluginOptionsListAndWatchGetPreferredAllocationAllocatePreStartContainer。本例没有设备初始化动作,因此 PreStartContainer 直接返回;GetPreferredAllocation 会优先保留 kubelet 指定的 MustIncludeDeviceIDs,再从可用列表中补足数量,它不负责最终占用设备。

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
func (p *devicePlugin) ListAndWatch(
    _ *pluginapi.Empty,
    stream pluginapi.DevicePlugin_ListAndWatchServer,
) error {
    if err := stream.Send(&pluginapi.ListAndWatchResponse{Devices: p.manager.Devices()}); err != nil {
        return err
    }
    for {
        select {
        case <-p.manager.HealthUpdates():
            if err := stream.Send(&pluginapi.ListAndWatchResponse{Devices: p.manager.Devices()}); err != nil {
                return err
            }
        case <-stream.Context().Done():
            return nil
        }
    }
}

Allocate 在 Pod 容器创建前执行。本例返回一个环境变量,容器可以用它观察 kubelet 分配的设备 ID:

1
2
3
4
5
6
7
response.ContainerResponses = append(response.ContainerResponses,
    &pluginapi.ContainerAllocateResponse{
        Envs: map[string]string{
            "DEMO_DEVICE_IDS": strings.Join(containerRequest.DevicesIDs, ","),
        },
    },
)

真实设备通常还会在这里返回 ContainerAllocateResponse.Devices,例如 /dev/nvidia0 对应的 DeviceSpec;也可以返回 CDI device 名称。本文不返回虚假的设备文件,避免把「调度成功」误解为「硬件隔离已经实现」。

并发分配:kubelet 选择设备,插件负责校验和准备

gRPC 服务端可以同时处理多个 Allocate 请求。这里要区分两类状态:

  1. 哪些设备已经分配:由 kubelet Device Manager 维护。它先从健康且未分配的设备中选出 ID,再把这些 ID 传给插件;插件不应在 Allocate 中再次扫描设备池。Kubernetes 的 Device Manager 源码还明确把插件 RPC 放在 Device Manager 的互斥锁之外执行,因为 RPC 可能比较耗时。
  2. 如何让设备可用:由插件或设备管理器负责。例如绑定 VFIO、生成 CDI 配置、修改设备状态等。如果这些操作共享可变状态,就必须在插件侧串行化,并让失败和重试保持幂等。

NVIDIA kubevirt-gpu-device-plugin 的 Allocate 采用的也是这个边界:先验证 kubelet 传入的设备 ID,再根据 ID 生成环境变量和 DeviceSpec,而不是在插件里重新挑选 GPU。它没有单独的 Unallocate RPC,因此插件不应仅凭 Allocate 调用维护一份永久占用表。

本实验的插件虽然只返回环境变量,仍用互斥锁保护插件侧的分配阶段,并拒绝同一个 AllocateRequest 中重复出现的设备 ID。下面只展示相关字段和方法,其他 import 省略:

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
type devicePlugin struct {
    resourceName string
    socket       string
    manager      resourceManager
    // kubelet 已经选择设备 ID;此锁只保护插件侧准备动作。
    allocateMu sync.Mutex
}

func (p *devicePlugin) Allocate(_ context.Context, request *pluginapi.AllocateRequest) (*pluginapi.AllocateResponse, error) {
    p.allocateMu.Lock()
    defer p.allocateMu.Unlock()

    // 校验设备 ID,并拒绝同一请求中重复分配同一个设备。
    // 然后生成 ContainerAllocateResponse。
}

这个锁不替代 kubelet 的设备分配状态;它只保证插件自己的硬件准备逻辑不会并发修改同一份状态。对应测试位于 main_test.go。在 k8sdev 根目录运行 go test -race ./extended-resource,结果为:

1
ok  github.com/jimyag/k8sdev/extended-resource  1.927s

Pod 如何申请这种资源

extended resource 使用和 GPU 一样的 resources 字段。数量是整数,不能写 500m 这样的 CPU quantity;通常同时设置 requestslimits

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
# 申请一个 FPGA;requests 和 limits 保持一致,便于直接观察资源消耗。
apiVersion: v1
kind: Pod
metadata:
  name: fpga-consumer
spec:
  containers:
    - name: consumer
      image: alpine:3.22
      command: ["sh", "-c", "echo DEMO_DEVICE_IDS=$DEMO_DEVICE_IDS; sleep 3600"]
      resources:
        requests:
          example.com/fpga: "1" # 调度器按这个值扣减节点余量。
        limits:
          example.com/fpga: "1" # 设备类资源不能超过请求值。

节点报告 example.com/fpga: 2 时,两个这样的 Pod 可以同时被调度;第三个 Pod 申请 3 个时,调度器会因为 Insufficient example.com/fpga 让它保持 Pending

在 Kind 中实测

实验文件、脚本和结果都在 k8sdev 的 extended-resource/。下面的命令固定使用该提交:

1
2
3
4
5
6
7
git clone https://github.com/jimyag/k8sdev.git
git -C k8sdev checkout --detach 502068b97b2e41f51a4f65c3b62f2777ba800688
cd k8sdev/extended-resource

# 给实验使用独立 kubeconfig 和独立 Kind 集群名。
export KUBECONFIG=/tmp/extended-resource-lab.kubeconfig
KIND_CLUSTER_NAME=extended-resource-lab ./setup.sh

setup.sh 按以下顺序执行:

  1. 创建 kind-extended-resource-lab,默认节点镜像为 kindest/node:v1.35.0
  2. 在主机上编译静态 Device Plugin,构建镜像并加载到 Kind 节点。
  3. 创建 fpga-device-plugin DaemonSet,等待它完成 rollout。
  4. alpine:3.22 一起加载到节点,避免 workload 依赖节点直接访问 Docker Hub。

检查插件注册和两个成功申请:

1
./verify.sh

下面是关键输出,完整原始记录见 verification-m6-20260914.txt

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
NAME                                  FPGA
extended-resource-lab-control-plane   2

NAME                   READY   STATUS    NODE
fpga-consumer          1/1     Running   extended-resource-lab-control-plane
fpga-consumer-second   1/1     Running   extended-resource-lab-control-plane

Allocatable:
  example.com/fpga:   2

DEMO_DEVICE_IDS=fpga-0
DEMO_DEVICE_IDS=fpga-1

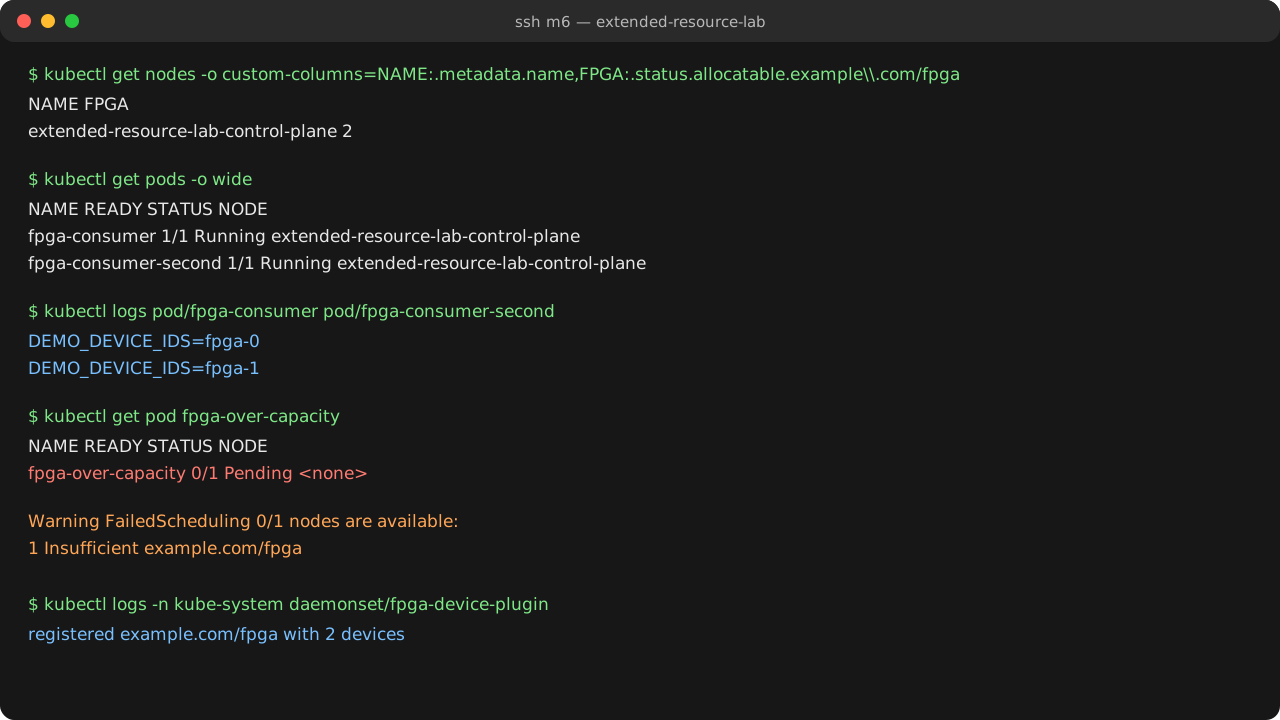
输出表明:节点状态包含扩展资源,两个 Pod 都已调度并运行,kubelet 触发了 Allocate,两个请求拿到了不同的设备 ID。

容量不足时会怎样

再创建一个申请三个设备的 Pod:

1
2
3
kubectl apply -f deploy/over-capacity.yaml
kubectl get pod fpga-over-capacity -o wide
kubectl get events --field-selector=involvedObject.name=fpga-over-capacity

调度事件为:

1
2
3
4
5
NAME                 READY   STATUS    NODE
fpga-over-capacity   0/1     Pending   <none>

Warning  FailedScheduling
0/1 nodes are available: 1 Insufficient example.com/fpga.

这与 CPU、memory 的调度结果一致:资源不足时 Pod 会保持 Pending,直到其他工作负载释放资源或请求被修改。

为了验证 kubelet 重启后的恢复路径,我在 Kind 节点中删除插件 socket,模拟 kubelet 清理旧 socket:

1
2
docker exec extended-resource-lab-control-plane \
  rm -f /var/lib/kubelet/device-plugins/example.com-fpga.sock

插件检测到 socket 被删除后会重新启动 server 并注册:

1
2
3
2026/09/14 02:58:33 registered example.com/fpga with 2 devices
2026/09/14 02:58:36 kubelet socket removed, re-registering example.com/fpga
2026/09/14 02:58:36 registered example.com/fpga with 2 devices

m6 上的 extended resource 验证输出

Kind 验证结束后删除本次独立集群:

1
kind delete cluster --name extended-resource-lab

实验边界

这次实验验证的是 Device Plugin、kubelet、节点 allocatable、调度器和 Allocate 之间的控制面链路,不包括以下生产能力:

  • 真实 FPGA/GPU 的驱动、设备文件或 CDI 配置正确;
  • 多容器、多进程对同一硬件的隔离策略正确;
  • 设备故障上报、热插拔、NUMA 拓扑和健康检查符合生产要求;
  • 本次 m6 实验没有覆盖多副本切换、设备插件升级和真实 kubelet 重启。

生产实现还应使用真实设备 ID,在 ListAndWatch 中上报健康变化,在 Allocate 中返回实际的 DeviceSpec 或 CDI 配置,并测试 kubelet 重启、插件重启、设备异常和节点扩缩容。

结论

要增加一种像 GPU 一样参与调度的资源,应从 Device Plugin 入手:插件向 kubelet 注册设备,kubelet 更新 Node 的 allocatable,调度器据此选择节点,最后由 kubelet 在 Allocate 阶段把设备访问配置交给容器。

CRD 适合扩展 Kubernetes API 对象;Device Plugin 适合扩展节点上可调度、可分配的设备类资源。先区分要扩展的是 API 层还是节点资源层,就能选对实现入口。

#Kubernetes #Device Plugin #Extended Resource #Kind